资料中心 DataFocus OT 产品介绍
DataFocus OT · 企业本体平台
让 AI 进入业务,控制权留在你手里
老板在催 AI 落地,员工已经在用外面的 AI 工具,IT 和法务却不敢把企业数据交出去。
DataFocus OT 用业务本体给 AI 三样东西:一张读得懂的业务地图、一条有边界的通道,以及一套要人批准的动作。这样,你可以放心地对 AI 说"可以"。
AI 进企业,缺的不是模型
今天的大模型已经很聪明,但放进企业里,常常缺三样东西。
缺上下文
模型不认识你的业务。它不知道 CRM、ERP 和合同里的"客户 A"是不是同一家,不知道"交付"算完工、发货还是签收,也不知道哪一版规则正在生效。直接给它数据库,它只能去猜表名、猜关联。
缺边界
让 AI 直接连数据,它能看什么、能改什么都不受控。给每个 AI 单独配一套权限,既配不过来,也很快对不上。
缺行动能力
只会回答问题的 AI 价值有限。企业要的是发现问题之后能推进处理,而且每一步都在规则之内、有人把关。
业务本体补的正是这三样。
什么是业务本体
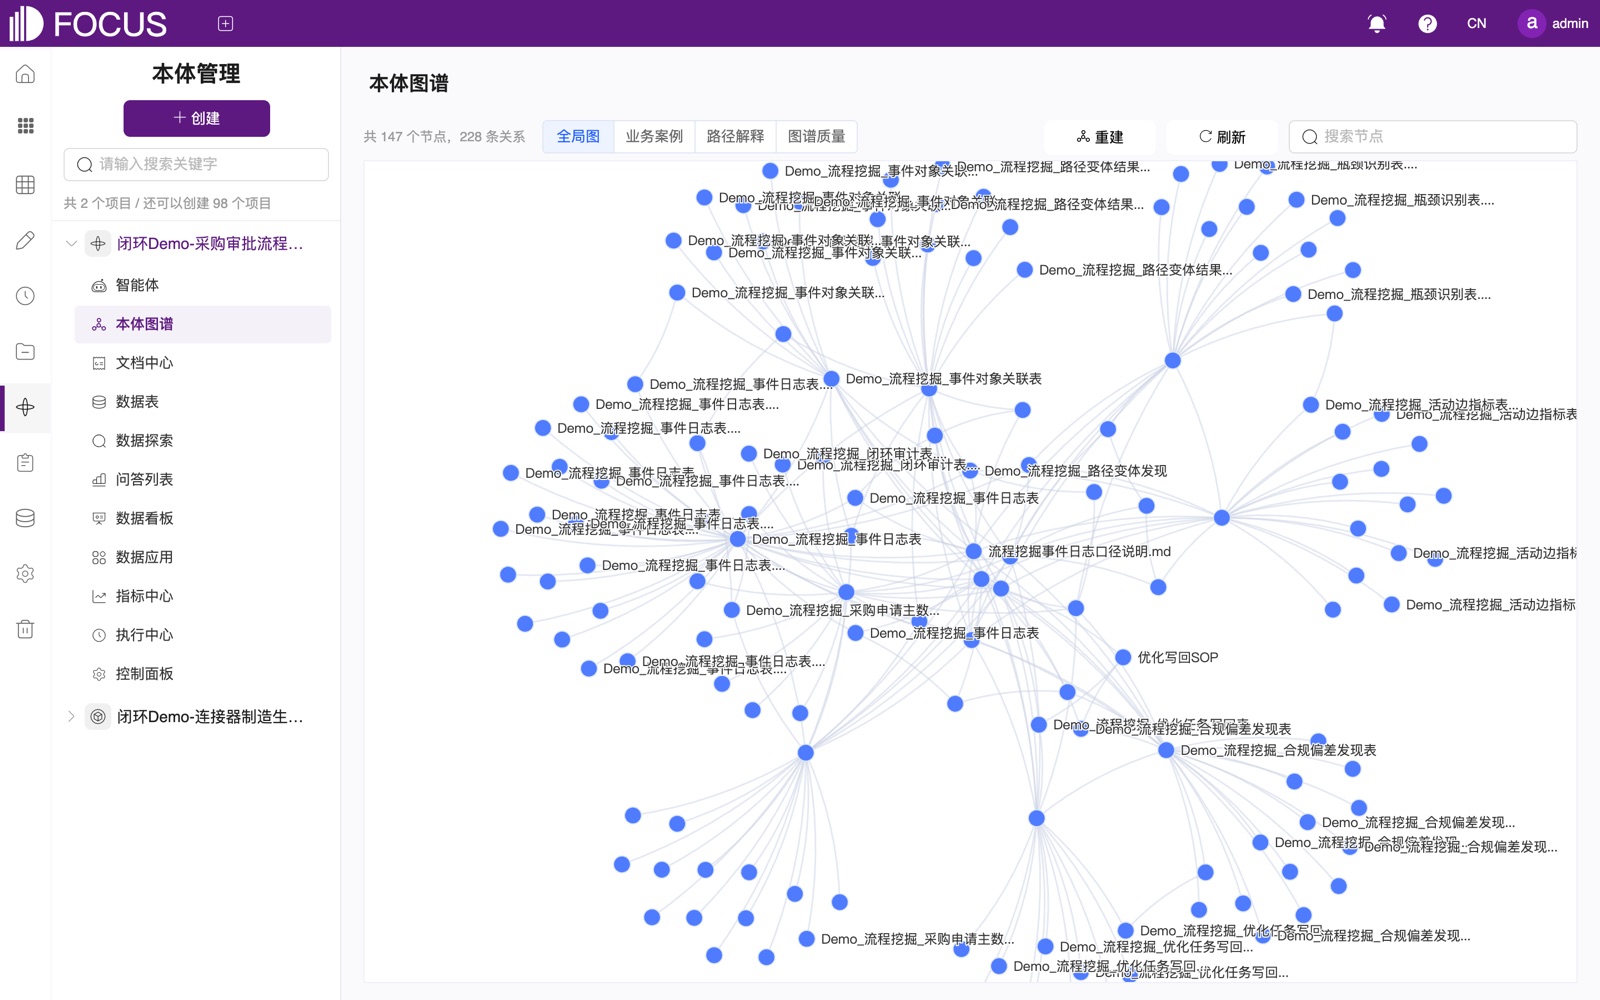
本体是围绕一个业务主题建立的业务模型。以产品内置的"采购审批"示例本体为例,它由五部分组成。
| 组成 | 在 DataFocus OT 中 | 采购审批本体里 |
|---|---|---|
| 业务对象与关系 | 把各系统的数据表组织到本体下,写明表与表如何关联及其业务含义,并在本体图谱中呈现 | 采购申请、审批事件日志、路径变体、瓶颈、合规偏差、优化任务、审计记录等 9 张表;例如"审计记录按案例编号追踪采购申请" |
| 规则与知识 | 文档中心存放制度、规则和口径说明,并关联到它们约束的数据 | 合规偏差校验规则、SLA 与瓶颈识别规则、事件日志口径说明、任务写回与审计 SOP |
| 指标 | 指标中心,按计划推送给相关人员 | — |
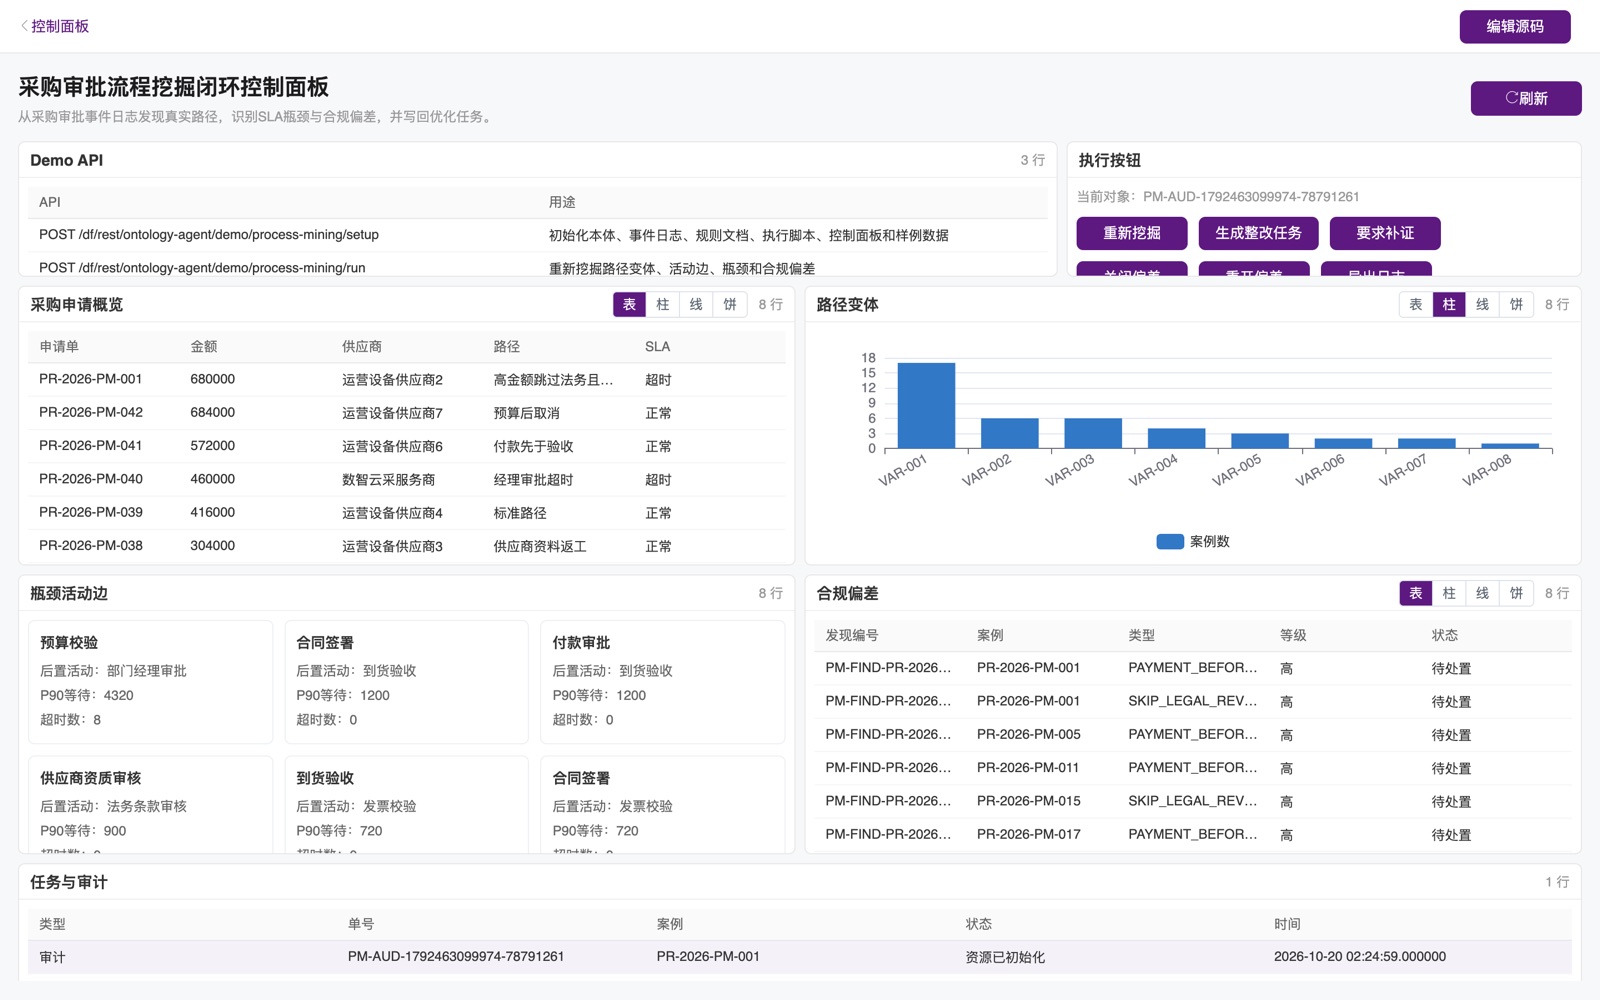
| 动作 | 执行脚本(计算、校验、写回);控制面板上的业务动作 | "合规偏差检测"脚本;面板上的重新挖掘、生成整改任务、要求补证、关闭偏差、重开偏差 |
| 权限 | 沿用企业的用户、角色和资源权限;按本体授权给 AI Agent | 只有被授权的人和 Agent 能看到这个本体 |
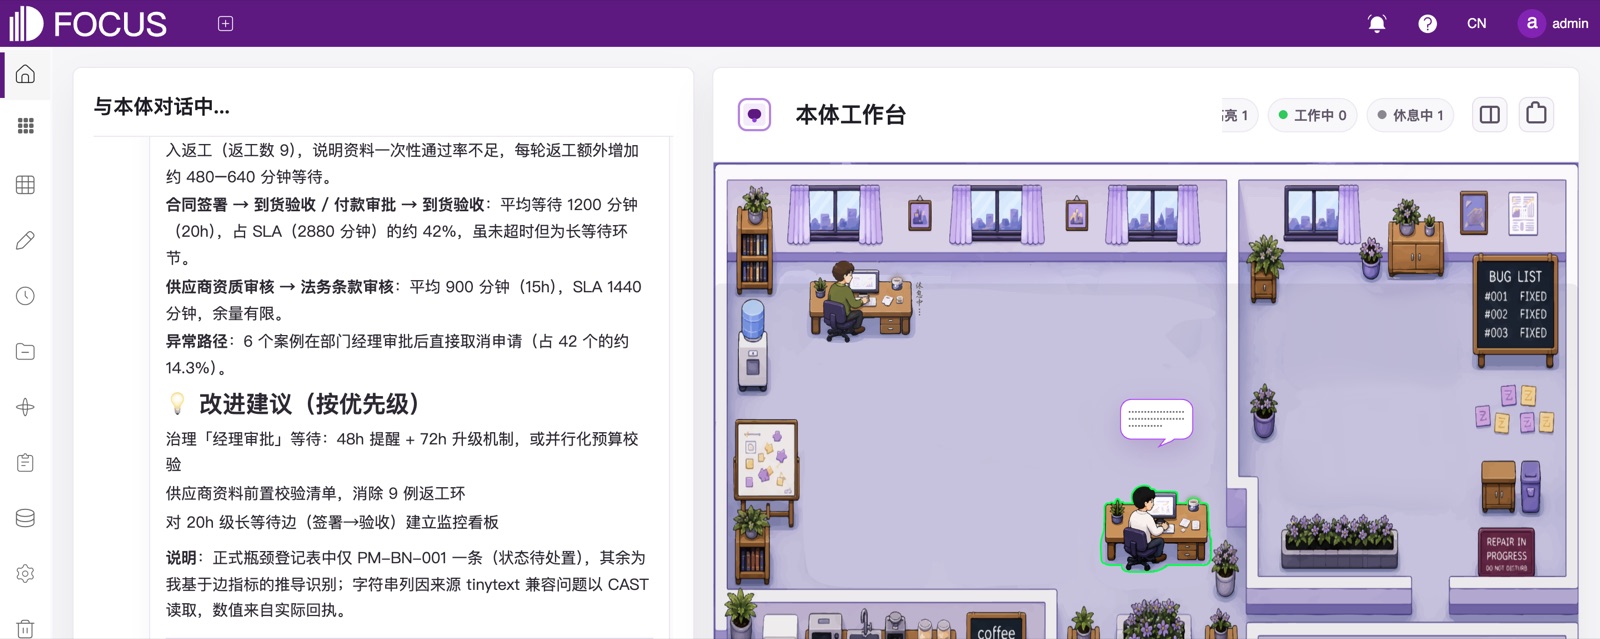
每个本体都配有一个本体智能体:用自然语言向它提问,它会结合本体中的数据和文档给出有依据的回答,还可以调用本体中的执行项完成分析或写回。
AI 帮你搭本体。搭本体不必从零手工开始:
- 界面上可以让 AI 生成执行脚本、生成和修改控制面板的草稿,校验、预览之后再保存;
- 外部 Agent 可以根据数据和文档起草本体,提出需要确认的业务问题,由业务负责人确认后发布。
看得见的证据
同一个问题,业务人员和 AI 得到同一组数字(使用产品内置的示例数据)。
业务人员 · 数据搜索输入"申请部门 金额"
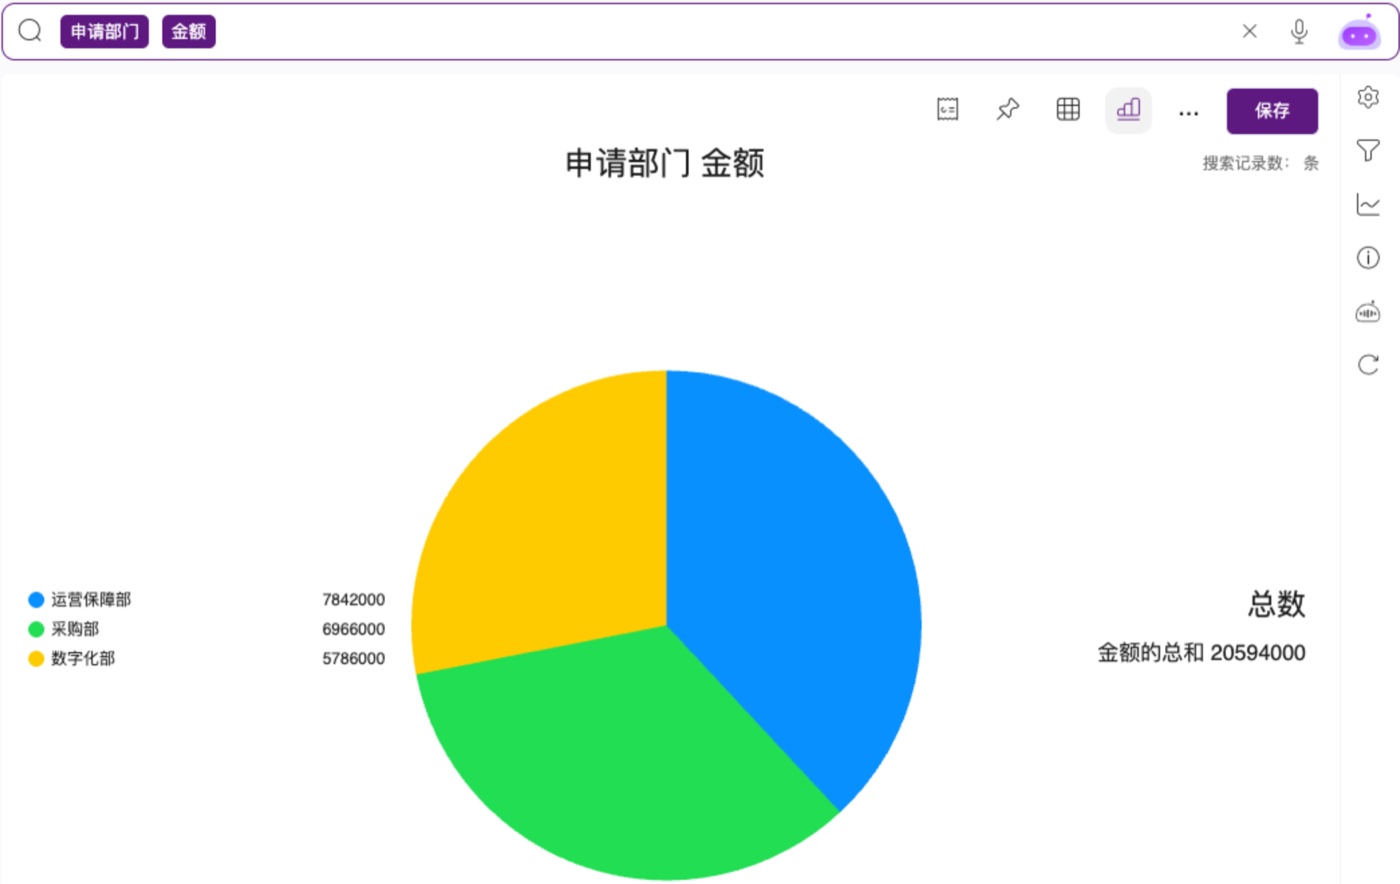
AI Agent · Claude Code 通过 MCP 问同一个问题
金额合计最高的是运营保障部,为 7,842,000 元。
- 运营保障部7,842,000
- 采购部6,966,000
- 数字化部5,786,000
依据:查询 Demo_流程挖掘_采购申请主数据表,执行 SELECT "申请部门", "币种", SUM("金额") … GROUP BY "申请部门", "币种";回执中的数据指纹 evidenceRowsSha256 = 98e5b99a…d159。(回答摘录)
两边的数字逐项相同
本体带来什么
一次定义,处处复用
业务口径在本体里只定义一次,搜索分析、看板、控制面板、本体智能体和外部 Agent 都用它,得到的是同一组数字。
AI 的回答有依据
AI 沿着本体里定义好的对象和关系去找数据,不靠猜;每次查询都返回实际执行的 SQL、所用的数据表和数据指纹。
AI 不越界
权限跟着本体走:Agent 只能拿到授权用户本人权限内的数据,越权请求不会透露数据是否存在,权限一收回就失效。
从发现问题到解决问题
业务人员在控制面板上选中一条异常,就能生成整改任务、要求补证或关闭偏差;AI 要做改动,只能提交草稿,经人批准后才会生效。
功能之外的价值
敢对 AI 说"可以"
很多企业卡在中间:老板催 AI 落地,IT 和法务不敢开放数据,员工已经在把数据复制给外面的 AI 工具。DataFocus OT 把"禁止"变成"受控地允许":有权限、能撤销、改动要批准。AI 用起来了,数据也不再从后门流出去。
掌握 AI 时代的主动权
模型更新得很快。业务知识沉淀在你自己服务器上的本体里,接入哪个模型、哪个 Agent 由你决定;换了也不用从头再来,业务知识也不会交给某一家 AI 厂商。
越用越值钱
第一个本体是投入。第二个场景可以复用已有的对象、规则和权限,每多一个 AI 应用,成本就更低。一次性的 AI 试点做完往往就扔了,本体会留下来。
出了错,能追到责任
每次查询都有回执,每次变更都有审批记录,Agent 的全部操作还会记入审计日志。用了哪份数据、按哪条规则、谁批准的,都查得到。AI 可以追责,管理层才敢放行。
知识留在公司
老员工脑子里的规则和处理办法变成本体。人员流动,知识还在;新同事和新的 AI 应用都从这里开始。
为什么是 DataFocus
很多产品都说自己有"本体"。常见的做法大致有四类。
| 做法 | 擅长 | 不足 |
|---|---|---|
| 知识图谱:从文档中抽取实体和关系 | 检索和问答 | 金额、汇总等数字靠模型生成,算不准;没有业务动作 |
| 指标层或语义层:数据平台自带 | 报表数字准确 | 没有规则文档和业务动作;绑定在该平台上 |
| 数据目录 | 说明数据在哪里、是什么 | 只描述数据,不参与业务运行 |
| 重型本体平台 | 功能完整 | 价格高、实施重,依赖驻场团队;AI 多绑定自家产品 |
DataFocus OT 的做法
数字算得准。底层是真实的计算引擎(Flash 用 Apache Doris,Heavy 用 Trino 等),回答来自实际执行的 SQL,并带可核对的回执,不让大模型去"估"数字。这建立在 DataFocus 搜索式分析产品的基础之上。
数据、规则、动作在同一个本体里。数据告诉你发生了什么,规则告诉你应该怎样,动作让你接着处理。
对 AI 开放,但默认受控。用标准 MCP 和 OAuth 接入任何支持 MCP 的 Agent;权限继承、实时撤销、变更审批、查询回执都是内建的,不是外挂的。
轻。私有化部署,Flash 一个引擎就能运行;从一个本体起步,不需要庞大的驻场团队;AI 还能帮你搭本体。
人和 AI 共用。业务人员手上的搜索分析、看板和推送,用的是同一个本体。投入一次,两边受益。
功能一览
业务人员
- 搜索式分析:输入列名和关键词即可得到图表,可查看实际执行的 SQL,支持时序预测和归因分析。
- 智能问数:用自然语言向 AI 助手"小慧"提问,由它转换成查询。
- 本体工作台:与本体智能体对话,由它结合数据和文档给出分析。
- 控制面板:查看业务状态,直接执行业务动作。
- 问答、数据看板,以及定时推送到企业微信、钉钉、飞书。
- 数据填报:设计填报表单,收集和管理数据。
- 21 种界面语言,包括简体中文、繁体中文、English、日本语、한국어。
AI Agent(通过 MCP 接入)
- 标准 MCP 接口(Streamable HTTP),通过 OAuth 授权;Claude Code 等客户端可以直接接入。
- 读取本体、资源和图谱,在本体范围内执行只读查询,结果附带 SQL 和数据指纹。
- 提交控制面板等变更草稿,经人工审批后应用。
- 通过 DataFocus 用自然语言完成分析,委托本体智能体执行任务
AI 自动建模研究
选定一张业务数据表、设定预测目标和评价指标后,AI 会按以下步骤完成建模研究:
- 先调查数据,再提出基线和候选方案;
- 调用平台训练模型并比较效果;
- 用一份事先留出、只用一次的数据,对选定的模型做独立评分;
- 确认有可靠提升才采用,没有提升就如实报告;
- 用户在页面上下载预测结果和模型训练包。
整个研究受预算和数据权限约束,可以暂停和恢复;收回数据权限后,研究会随之停止。
数据与 IT 团队
- 数据接入:导入数据表、接入外部数据源,建立数据集和公式。
- 数据治理:资产目录、资产全景、数据服务 API。
- 系统管理:组织架构、角色与资源权限、AD/LDAP 账号同步,以及外部 Agent 的操作能力和变更审批。
两个版本
| 对比项 | OT Flash | OT Heavy |
|---|---|---|
| 计算与存储 | Apache Doris,内存计算与数据仓库合一 | Hadoop、Hive、Trino、Iceberg |
| 业务本体 | 支持 | 支持 |
| AI Agent 接入(MCP) | 支持 | 支持 |
| 数据加工 | — | ETL(DataSpring,基于 Flink) |
| AutoML 与 AI 自动建模研究 | — | 支持 |
| 适合 | 想先在一个业务域快速建起本体,数据可以集中到一个分析引擎的团队 | 数据量大、已在使用大数据平台,并需要数据加工和建模的企业 |
第一步:从一个本体开始
- 选一个业务问题:有数据、有制度文档、有明确负责人,例如订单交付或采购审批。
- 带上相关的数据表和规则文档,建起第一个本体。
- 让业务人员先用起来,再授权一个 AI Agent 接入。
- 跑通之后,扩展到下一个业务主题。
- 私有化部署:安装在企业自己的服务器上。大模型服务由管理员在系统中配置;使用外部模型时,请按企业的数据政策确认传输范围。
- 配套资料:中英文用户手册(截图均取自真实产品界面),以及 Agent 与 MCP 接入手册。